Laboratorul industrial de AI unde soluția ta este
testată înainte de a fi lansată
Transformăm conceptele de automatizare în dovezi de concept funcționale — testându-le pe componente reale și hardware industrial înainte de a le instala pe linia ta de producție.
Rularea LLM-urilor la edge: ce am măsurat
Șapte configurații de modele LLM open-weight, testate în QLAB pe o stație HP ZGX Nano G1n AI Station (NVIDIA GB10 Grace Blackwell, 128 GB memorie unificată).
Până la 9×
mai rapid cu modele mixture-of-experts, la același buget de memorie
2,7×
mai rapid cu ponderi pe 4 biți, fără pierderi de calitate detectate în testele noastre
5×
răspunsuri mai rapide de la un model mai nou, la aceeași viteză de generare
Modelele mixture-of-experts sunt de până la 9× mai rapide la același buget de memorie
Viteza de generare a textului în funcție de memoria utilizată, șapte configurații de modele
| Model | Arhitectură | Memorie utilizată de model (GiB) | Viteză de generare (tokeni/s) |
|---|---|---|---|
| Qwen3.6-35B-A3B | Mixture-of-experts | 25,0 | 73,9 |
| gpt-oss-20b | Mixture-of-experts | 15,4 | 61,5 |
| gpt-oss-120b | Mixture-of-experts | 64,6 | 42,3 |
| Qwen3.6-27B · 4 biți | Dens | 21,1 | 13,2 |
| Qwen3.8-27B · 4 biți | Dens | 21,3 | 12,8 |
| Qwen3.8-27B · 8 biți | Dens | 32,6 | 8,3 |
| Qwen3.8-27B · 16 biți | Dens | 56,4 | 4,7 |
Modelele mixture-of-experts își împart ponderile în mulți „experți” mai mici și folosesc doar câțiva dintre ei pentru fiecare token. La o cantitate similară de memorie, gpt-oss-120b a generat 42 de tokeni pe secundă, față de 5 pentru modelul dens Qwen3.8-27B pe 16 biți.
Folosim aceste date pentru a alege modelul și hardware-ul pentru SYA și pentru implementările AI on-premise, înainte de a instala ceva.
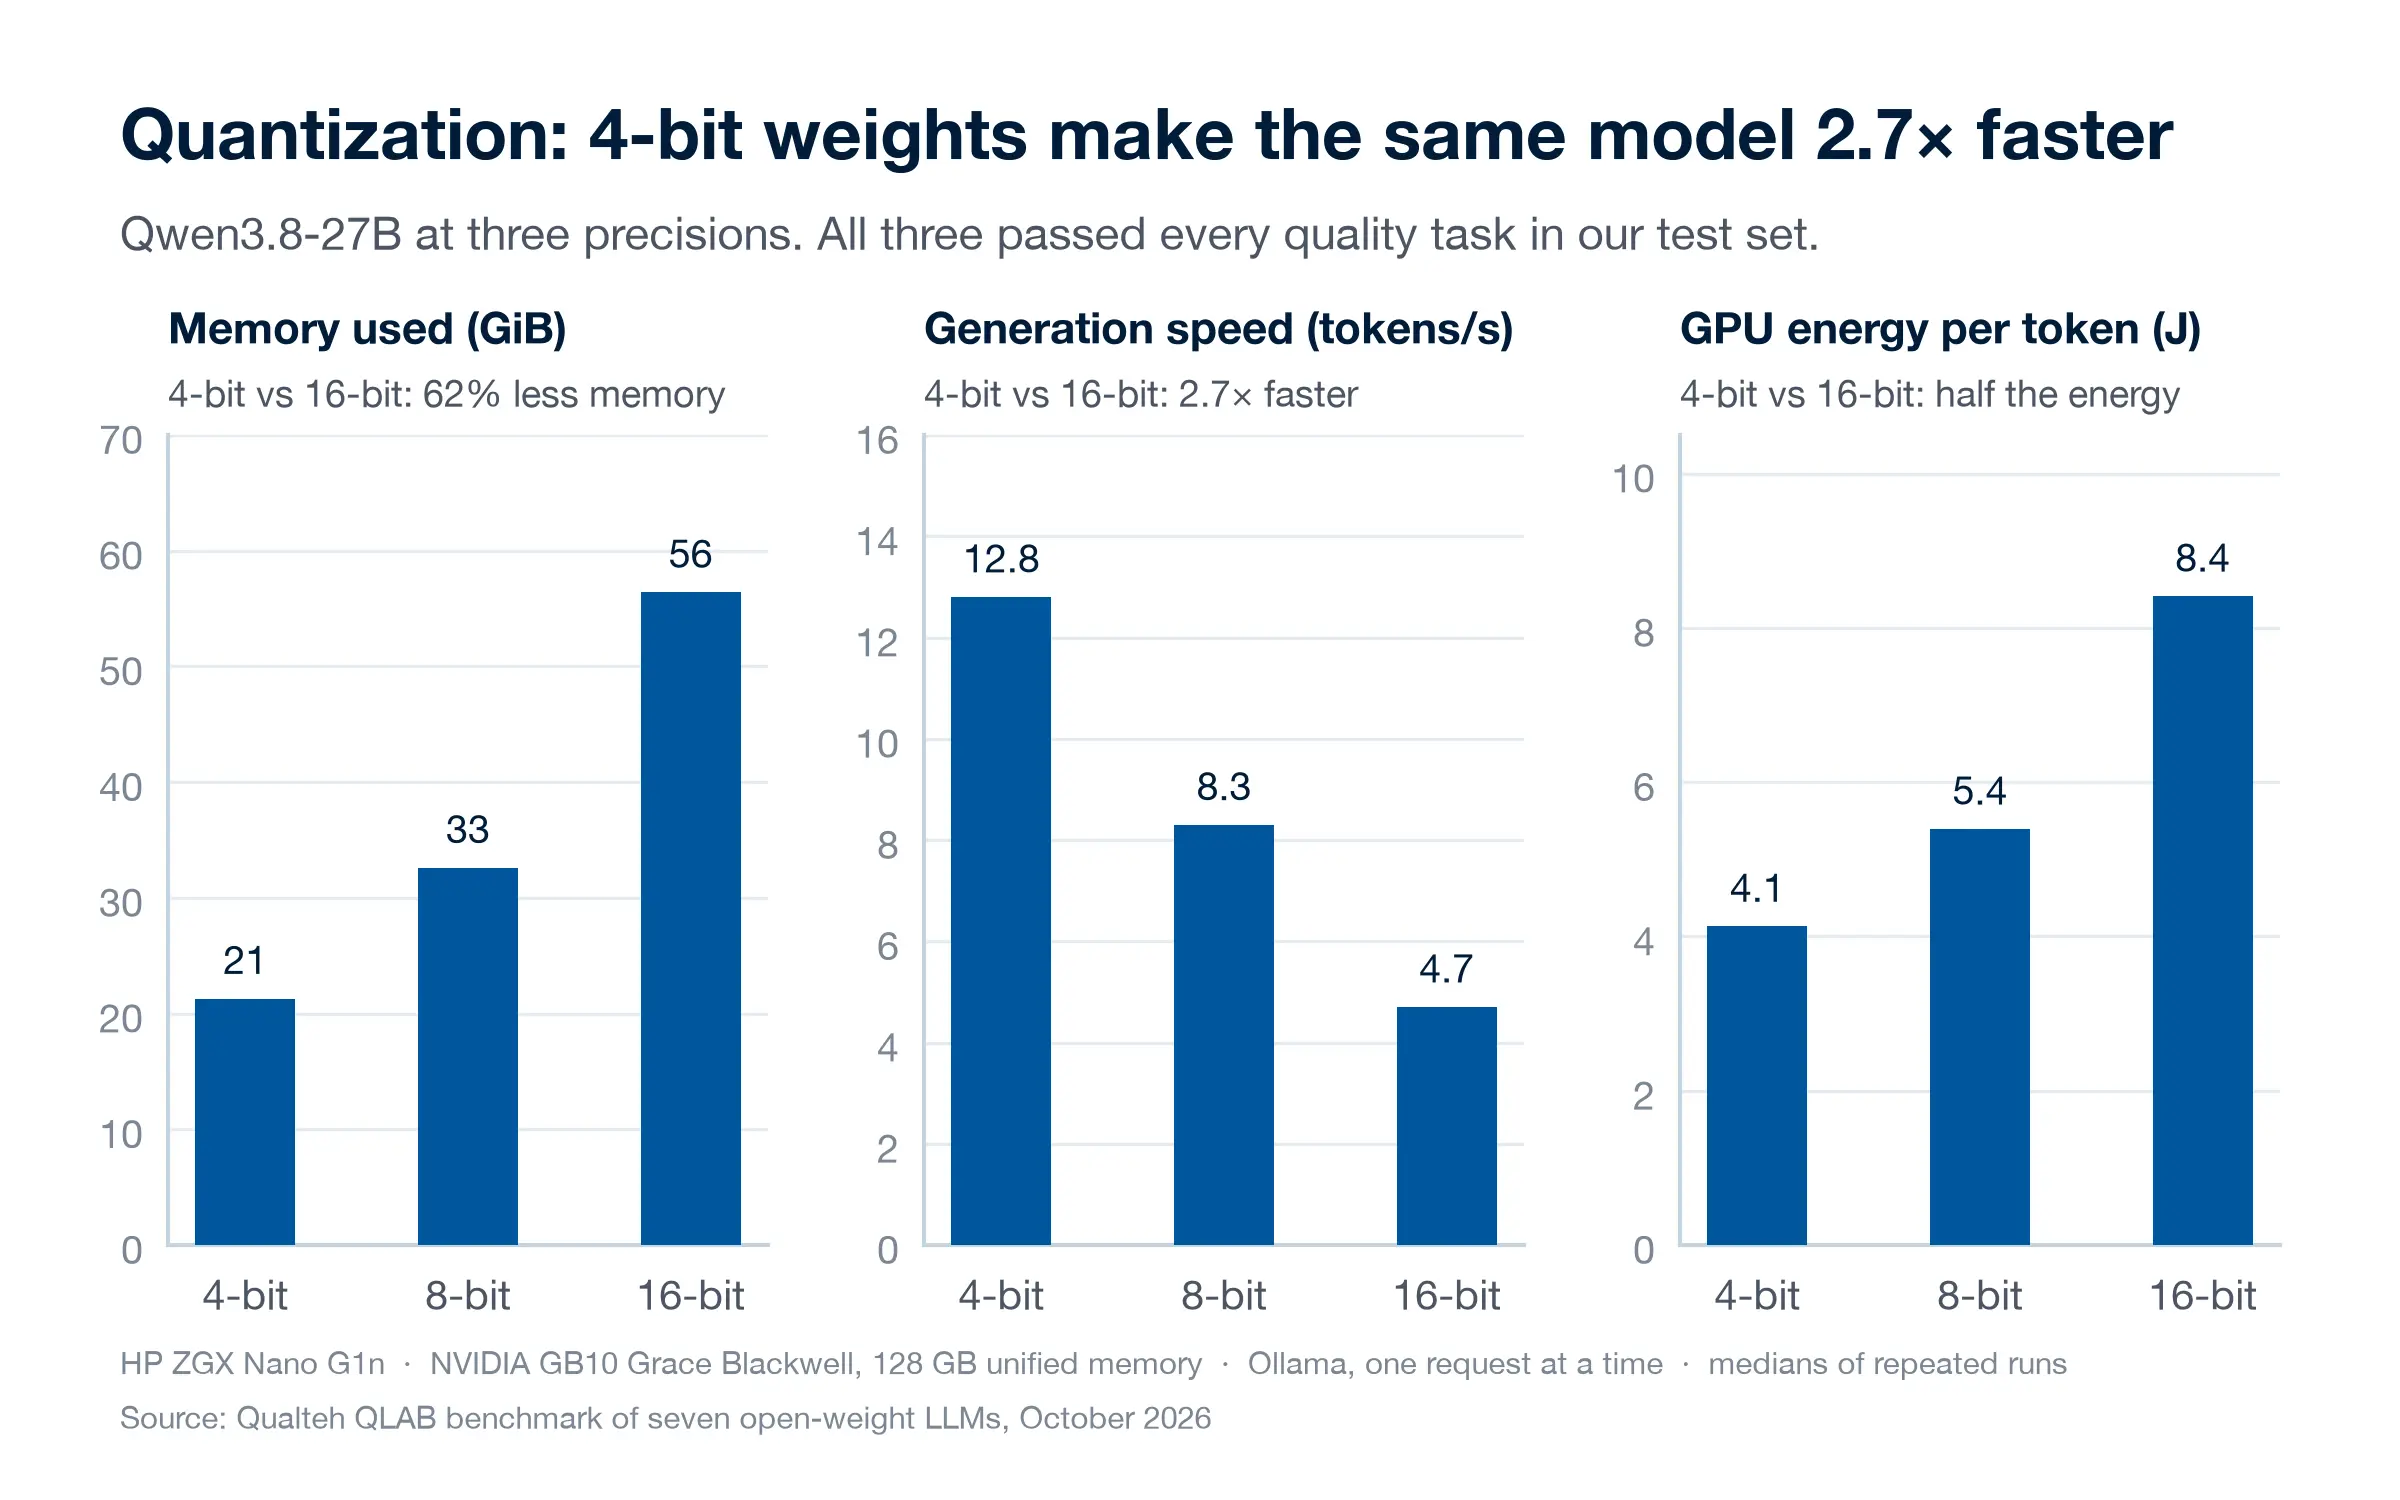 Cuantizare: ponderile pe 4 biți fac același model de 2,7× mai rapidMărime completă
Stocarea ponderilor pe 4 biți în loc de 16 a redus memoria de la 56 la 21 GiB și a înjumătățit energia per token. Toate cele trei versiuni au trecut fiecare sarcină de calitate din setul nostru, deci versiunea mai mică nu a pierdut nimic din ce am putut măsura.
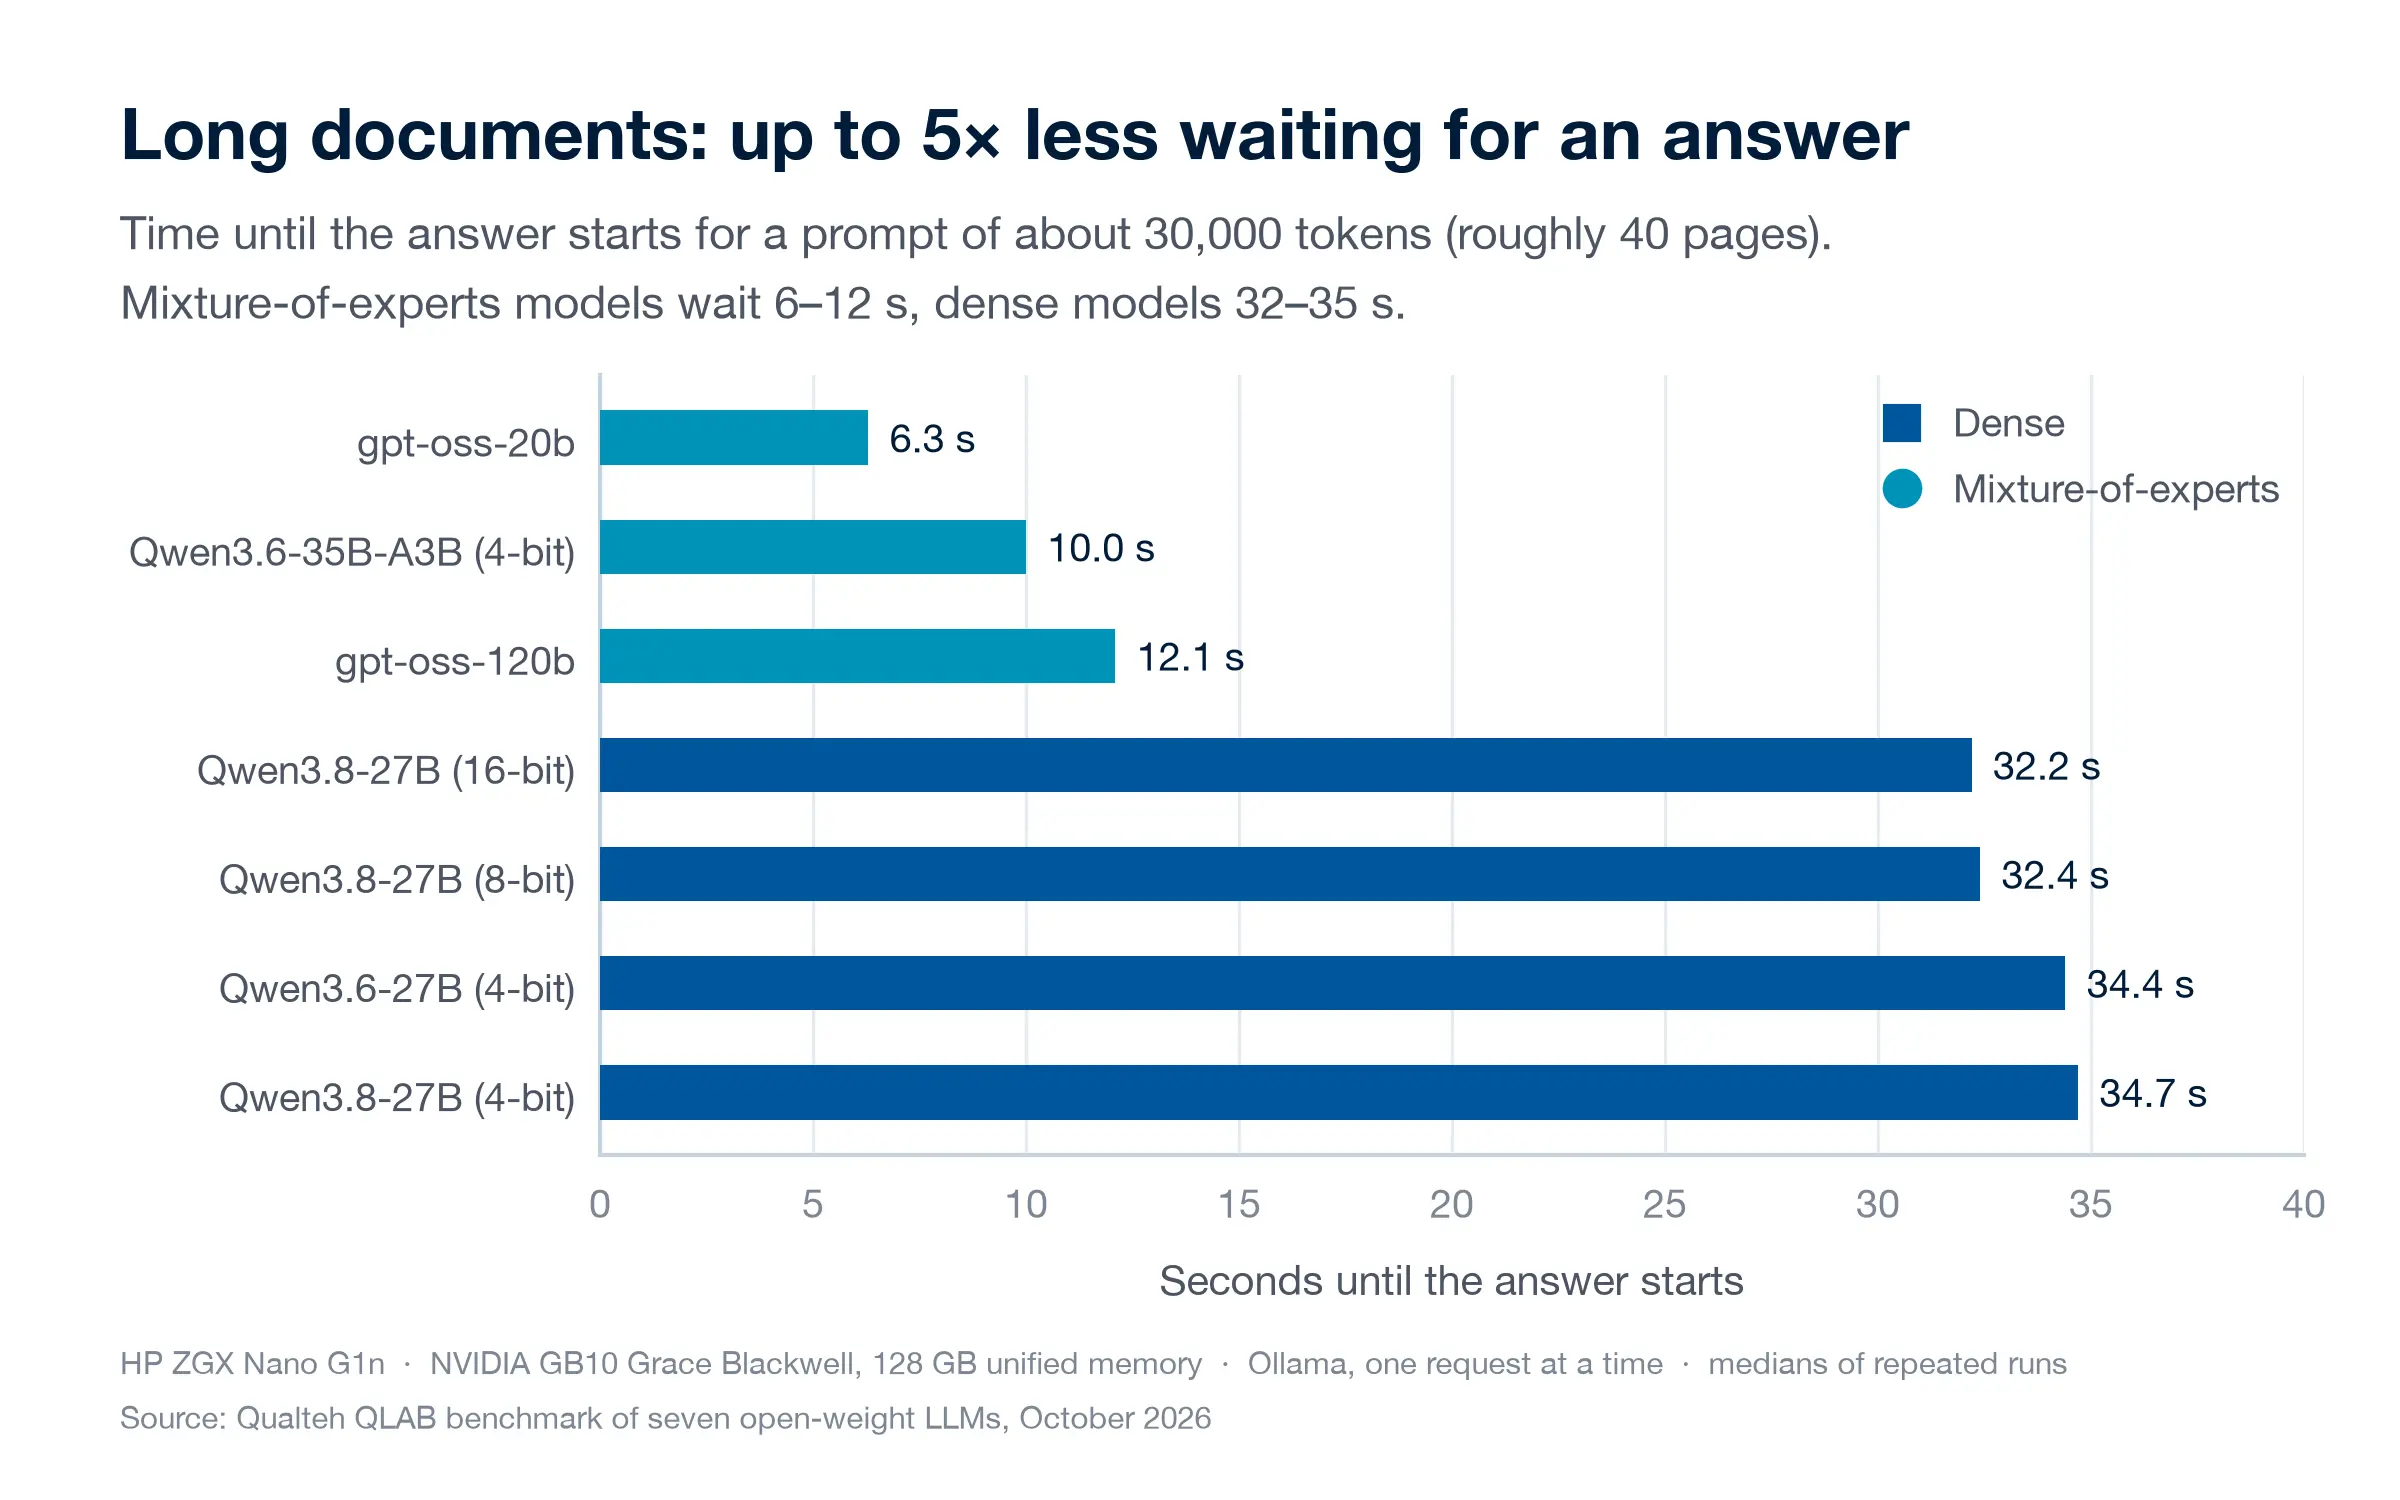 Documente lungi: de până la 5× mai puțină așteptare pentru un răspunsMărime completă
Pentru un prompt de aproximativ 40 de pagini, modelele mixture-of-experts au început să răspundă după 6–12 secunde, iar modelele dense după 32–35. Este așteptarea pe care utilizatorii o simt atunci când un asistent citește manuale, contracte sau rapoarte lungi.
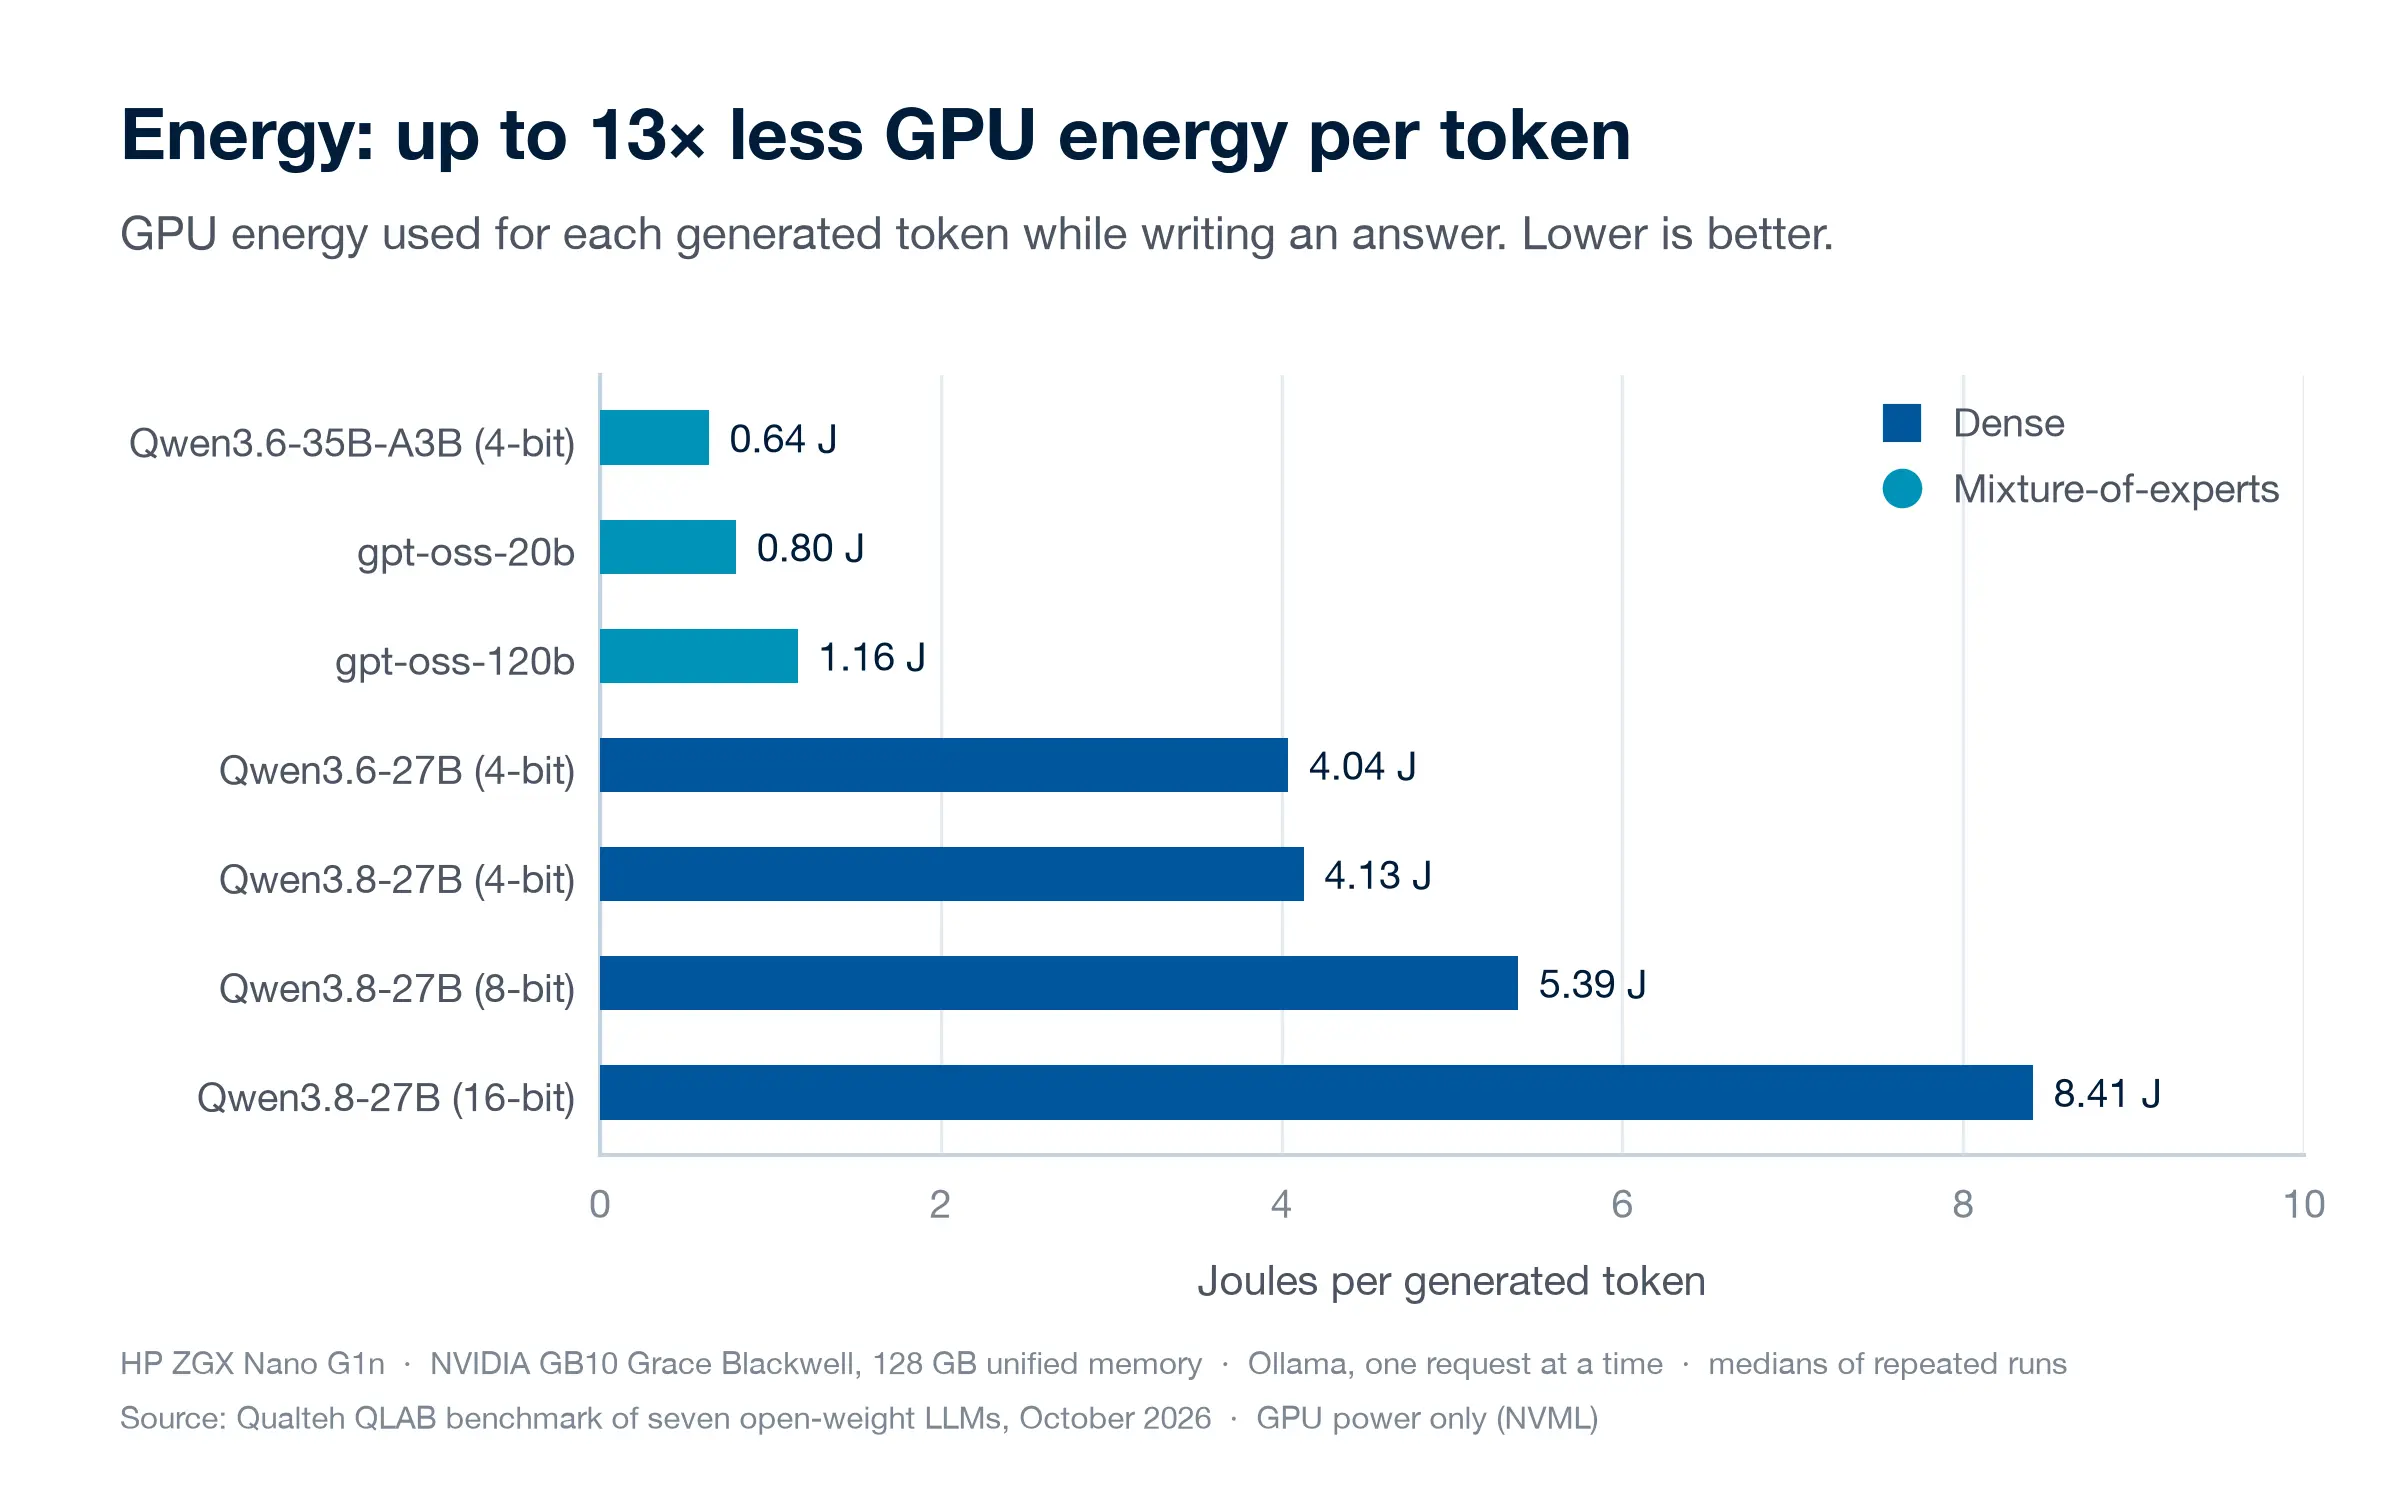 Energie: de până la 13× mai puțină energie GPU per tokenMărime completă
Pentru că folosesc doar o parte din ponderi pentru fiecare token, modelele mixture-of-experts au avut nevoie de 0,64–1,16 J per token, față de 4,04–8,41 J pentru modelele dense. Pe un sistem care funcționează toată ziua, diferența contează.
Cum am testat
- Hardware
- HP ZGX Nano G1n AI Station, cu un cip NVIDIA GB10 Grace Blackwell. Cei 128 GB de memorie unificată sunt partajați de CPU și GPU, așa că până și cel mai mare model testat, gpt-oss-120b, cu 65 GiB, încape pe o singură unitate.
- Modele
- Șapte configurații de modele open-weight, care pot rula în întregime pe hardware-ul propriu: trei modele mixture-of-experts (gpt-oss-20b, gpt-oss-120b, Qwen3.6-35B-A3B) și două modele dense de 27B (Qwen3.6-27B și Qwen3.8-27B pe 4, 8 și 16 biți).
- Ce am măsurat
- Viteza de generare, memoria utilizată, timpul până la începutul răspunsului pentru un prompt de aproximativ 30.000 de tokeni, energia GPU per token generat și calitatea răspunsurilor pe un set mic de sarcini.
Măsurat cu Ollama, câte o cerere pe rând, pe propria noastră unitate (18–19 octombrie 2026). Valorile sunt mediane ale mai multor rulări; consumul de energie este doar al GPU-ului. Setul de sarcini de calitate este mic, așa că rezultatul este un indiciu, nu un clasament.
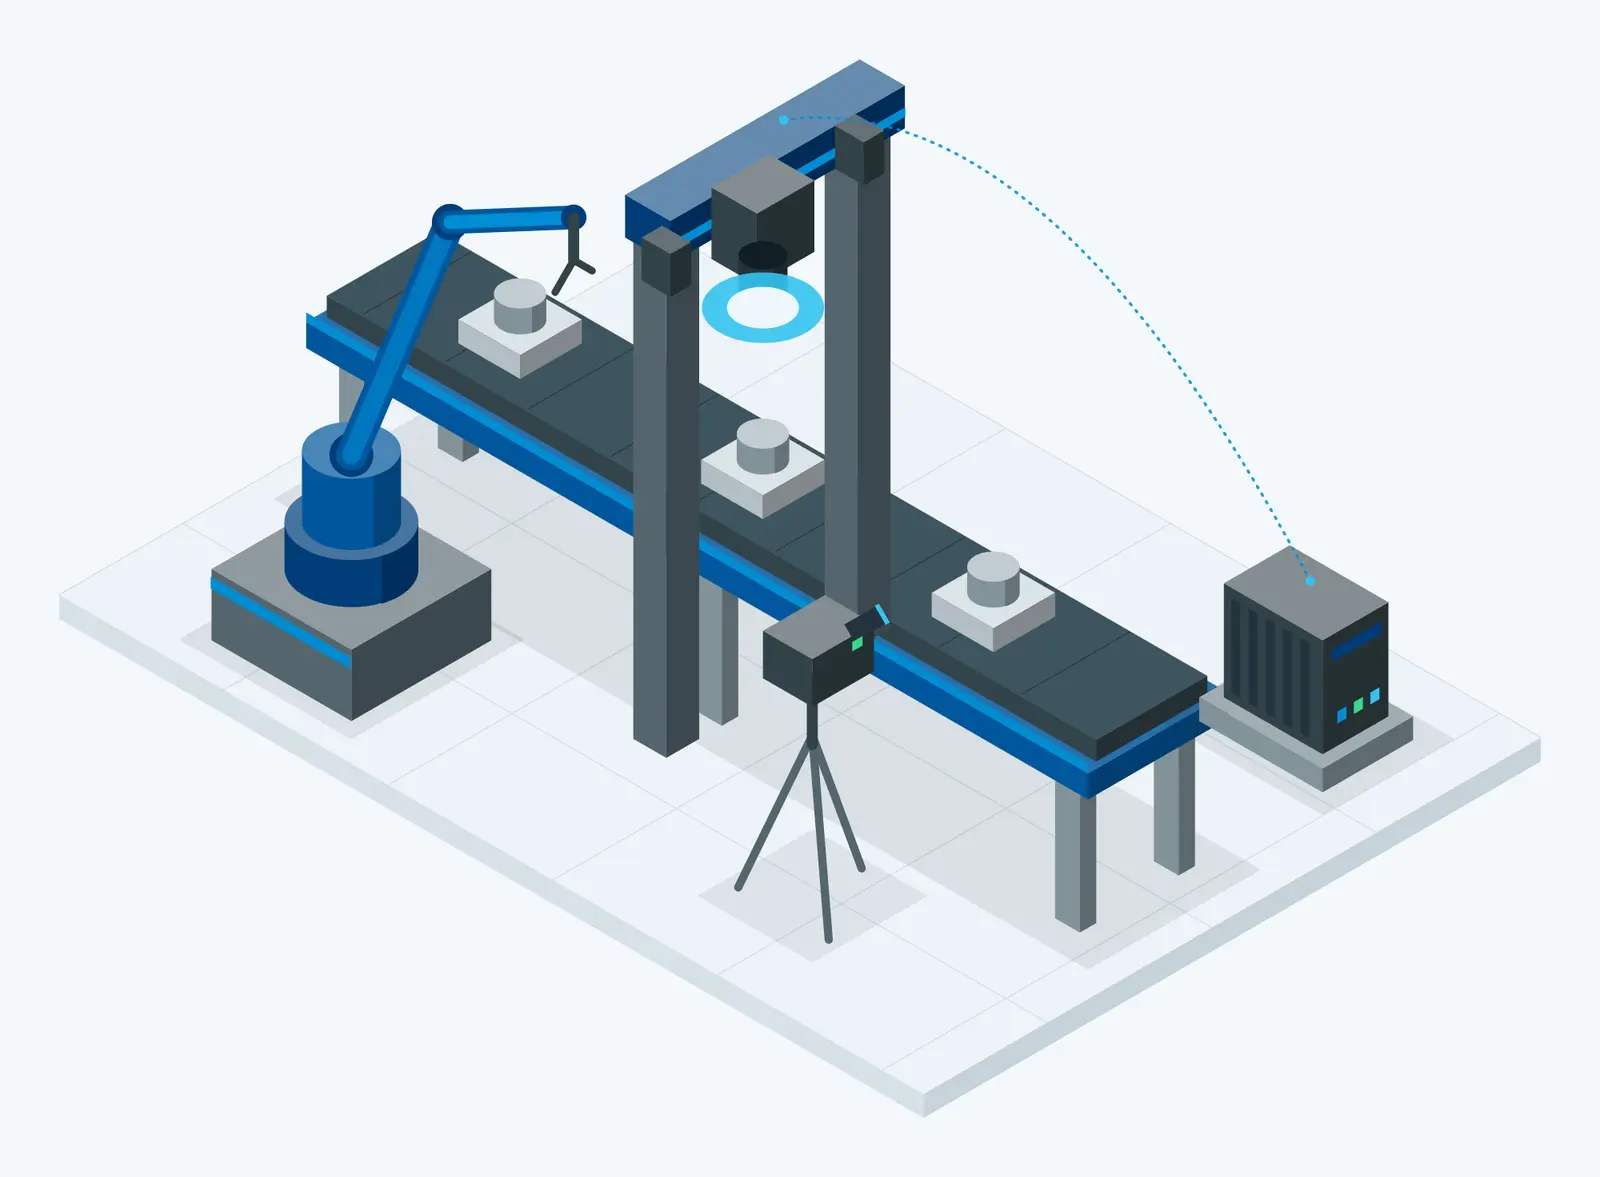
De la concept la producție, fără riscuri operaționale
Reproducem în laborator condițiile tale de producție — piese, mișcare, optică, iluminare și putere de calcul — și livrăm o dovadă de concept testată pe hardware industrial real.
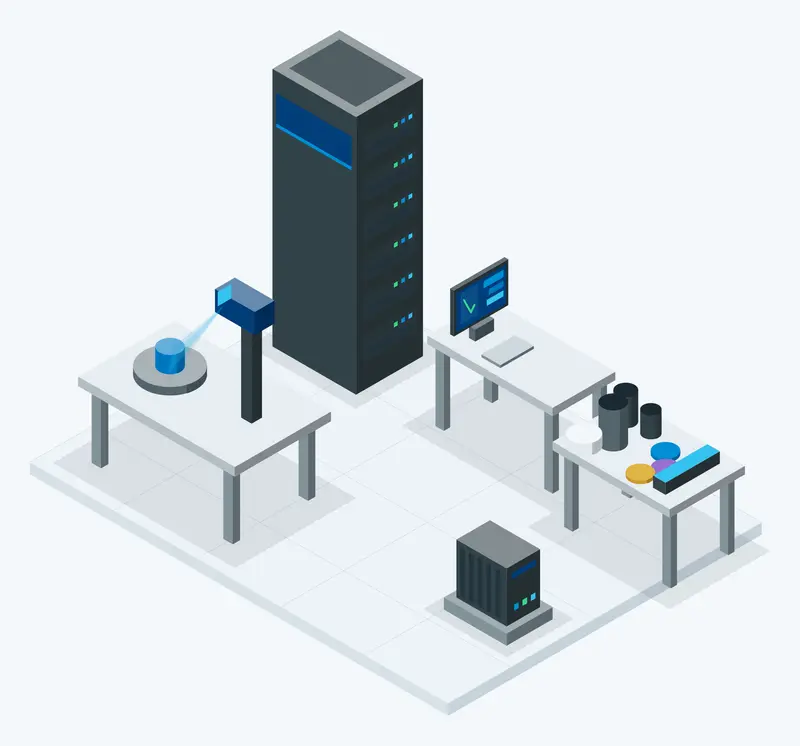
Server Industrial Edge AI
Calculatoare Industriale Edge AI
Brațe Robotice
Benzi Transportoare
Camere Industriale 2D
Lentile și Filtre Industriale
Iluminat Industrial
Scaner 3D de Înaltă Precizie
Mese și Standuri de Inspecție
Cele Mai Noi Modele AI
Tehnologii Excelente
Echipă de Ingineri Experți
Cum lucrăm
- 1
Descoperire & Fezabilitate
Analizăm procesul tău, piesele și cerințele de calitate, și definim criterii de succes măsurabile.
- 2
Configurarea Celulei de Laborator
Construim celula ta de inspecție în QLAB: camere, optică, iluminare, mișcare și calcul edge.
- 3
Antrenare AI Personalizată
Colectăm date pe piesele tale reale și antrenăm modele AI dedicate, de ultimă generație, pentru cazul tău.
- 4
PoC Testat în Laborator
Soluția completă rulează end-to-end în laborator și este validată pe baza criteriilor stabilite.
- 5
Lansare în Producție
Abia apoi implementăm în mediul tău de producție — predictibil și cu întreruperi minime.
Platforma SYONEEX.AI
VISYA
Sistem industrial de AI vizual pentru inspecția calității, decizii OK/NOT OK, monitorizare pas-cu-pas a producției și analiză de date pentru îmbunătățire continuă — 24/7, la orice scară.
Descoperă VISYA →Agent AISYA
Agenți AI personalizați care oferă angajaților, partenerilor și clienților acces direct și inteligent la sistemele companiei, documentație și cunoștințe — fără căutări obositoare, fără fricțiuni.
Descoperă SYA →Ingineri care vorbesc limbajul software, optică, AI — și cel al fabricii
Descarcă flyerul produsului
O prezentare concisă a acestei soluții — tot ce ai nevoie pentru a împărtăși cu echipa ta sau cu factorii de decizie.
Sunteți gata să solicitați un demo?
Alăturați-vă companiilor internaționale care utilizează soluțiile Qualteh.