Das industrielle KI-Labor, in dem Ihre Lösung
getestet wird, bevor sie in Betrieb geht
Wir verwandeln Automatisierungskonzepte in funktionierende Proof-of-Concepts — getestet an echten Teilen und industrieller Hardware, bevor sie auf Ihrer Produktionslinie installiert werden.
LLMs am Edge: Was wir gemessen haben
Sieben Open-Weight-LLM-Konfigurationen, getestet im QLAB auf einer HP ZGX Nano G1n AI Station (NVIDIA GB10 Grace Blackwell, 128 GB Unified Memory).
Bis zu 9×
schneller mit Mixture-of-Experts-Modellen bei gleichem Speicherbudget
2,7×
schneller mit 4-Bit-Gewichten, ohne festgestellten Qualitätsverlust in unseren Aufgaben
5×
schnellere Antworten von einem neueren Modell bei gleicher Generierungsgeschwindigkeit
Mixture-of-Experts-Modelle sind bei gleichem Speicherbudget bis zu 9× schneller
Textgenerierungsgeschwindigkeit im Verhältnis zum belegten Speicher, sieben Modellkonfigurationen
| Modell | Architektur | Vom Modell belegter Speicher (GiB) | Generierungsgeschwindigkeit (Tokens/s) |
|---|---|---|---|
| Qwen3.6-35B-A3B | Mixture-of-Experts | 25,0 | 73,9 |
| gpt-oss-20b | Mixture-of-Experts | 15,4 | 61,5 |
| gpt-oss-120b | Mixture-of-Experts | 64,6 | 42,3 |
| Qwen3.6-27B · 4-Bit | Dense | 21,1 | 13,2 |
| Qwen3.8-27B · 4-Bit | Dense | 21,3 | 12,8 |
| Qwen3.8-27B · 8-Bit | Dense | 32,6 | 8,3 |
| Qwen3.8-27B · 16-Bit | Dense | 56,4 | 4,7 |
Mixture-of-Experts-Modelle teilen ihre Gewichte in viele kleinere „Experten“ auf und nutzen für jedes Token nur wenige davon. Bei ähnlichem Speicherbedarf erzeugte gpt-oss-120b 42 Tokens pro Sekunde, das Dense-Modell Qwen3.8-27B mit 16 Bit dagegen 5.
Mit diesen Daten wählen wir Modell und Hardware für SYA und On-Premise-KI-Installationen aus, bevor irgendetwas installiert wird.
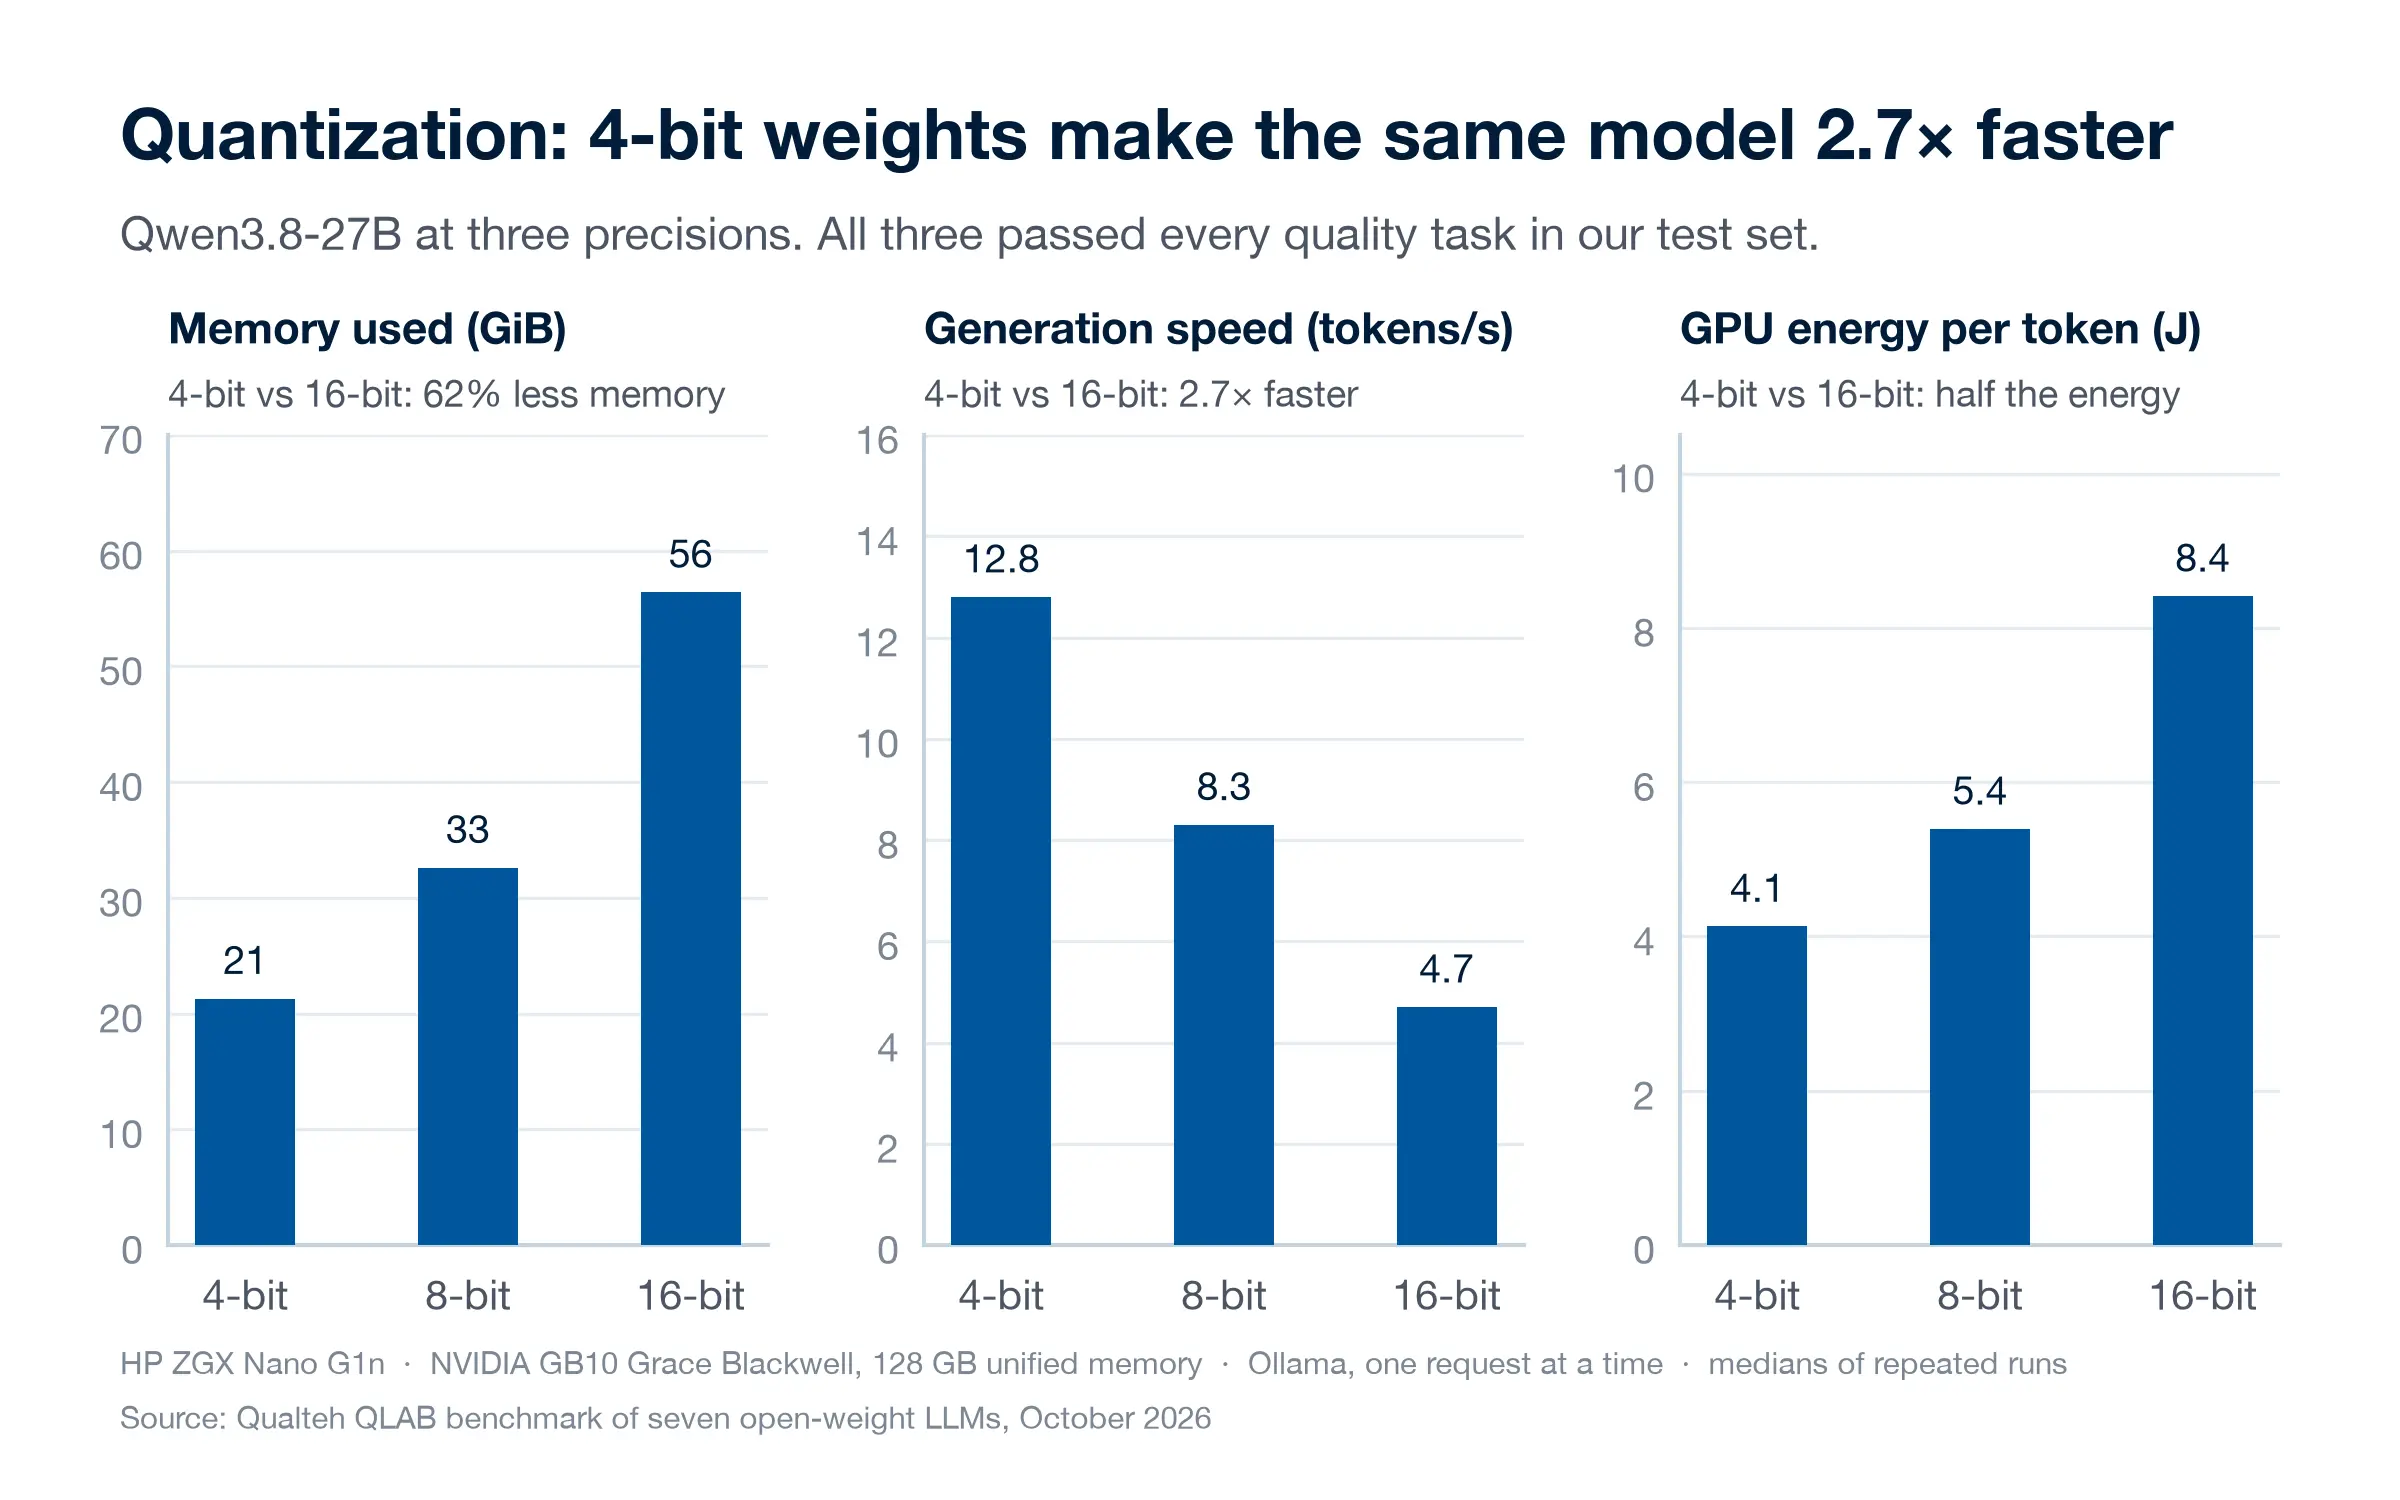 Quantisierung: 4-Bit-Gewichte machen dasselbe Modell 2,7× schnellerVolle Größe
Mit 4-Bit- statt 16-Bit-Gewichten sank der Speicherbedarf von 56 auf 21 GiB, und die Energie pro Token halbierte sich. Alle drei Varianten bestanden jede Qualitätsaufgabe unseres Sets; die kleinere Variante verlor also nichts, was wir messen konnten.
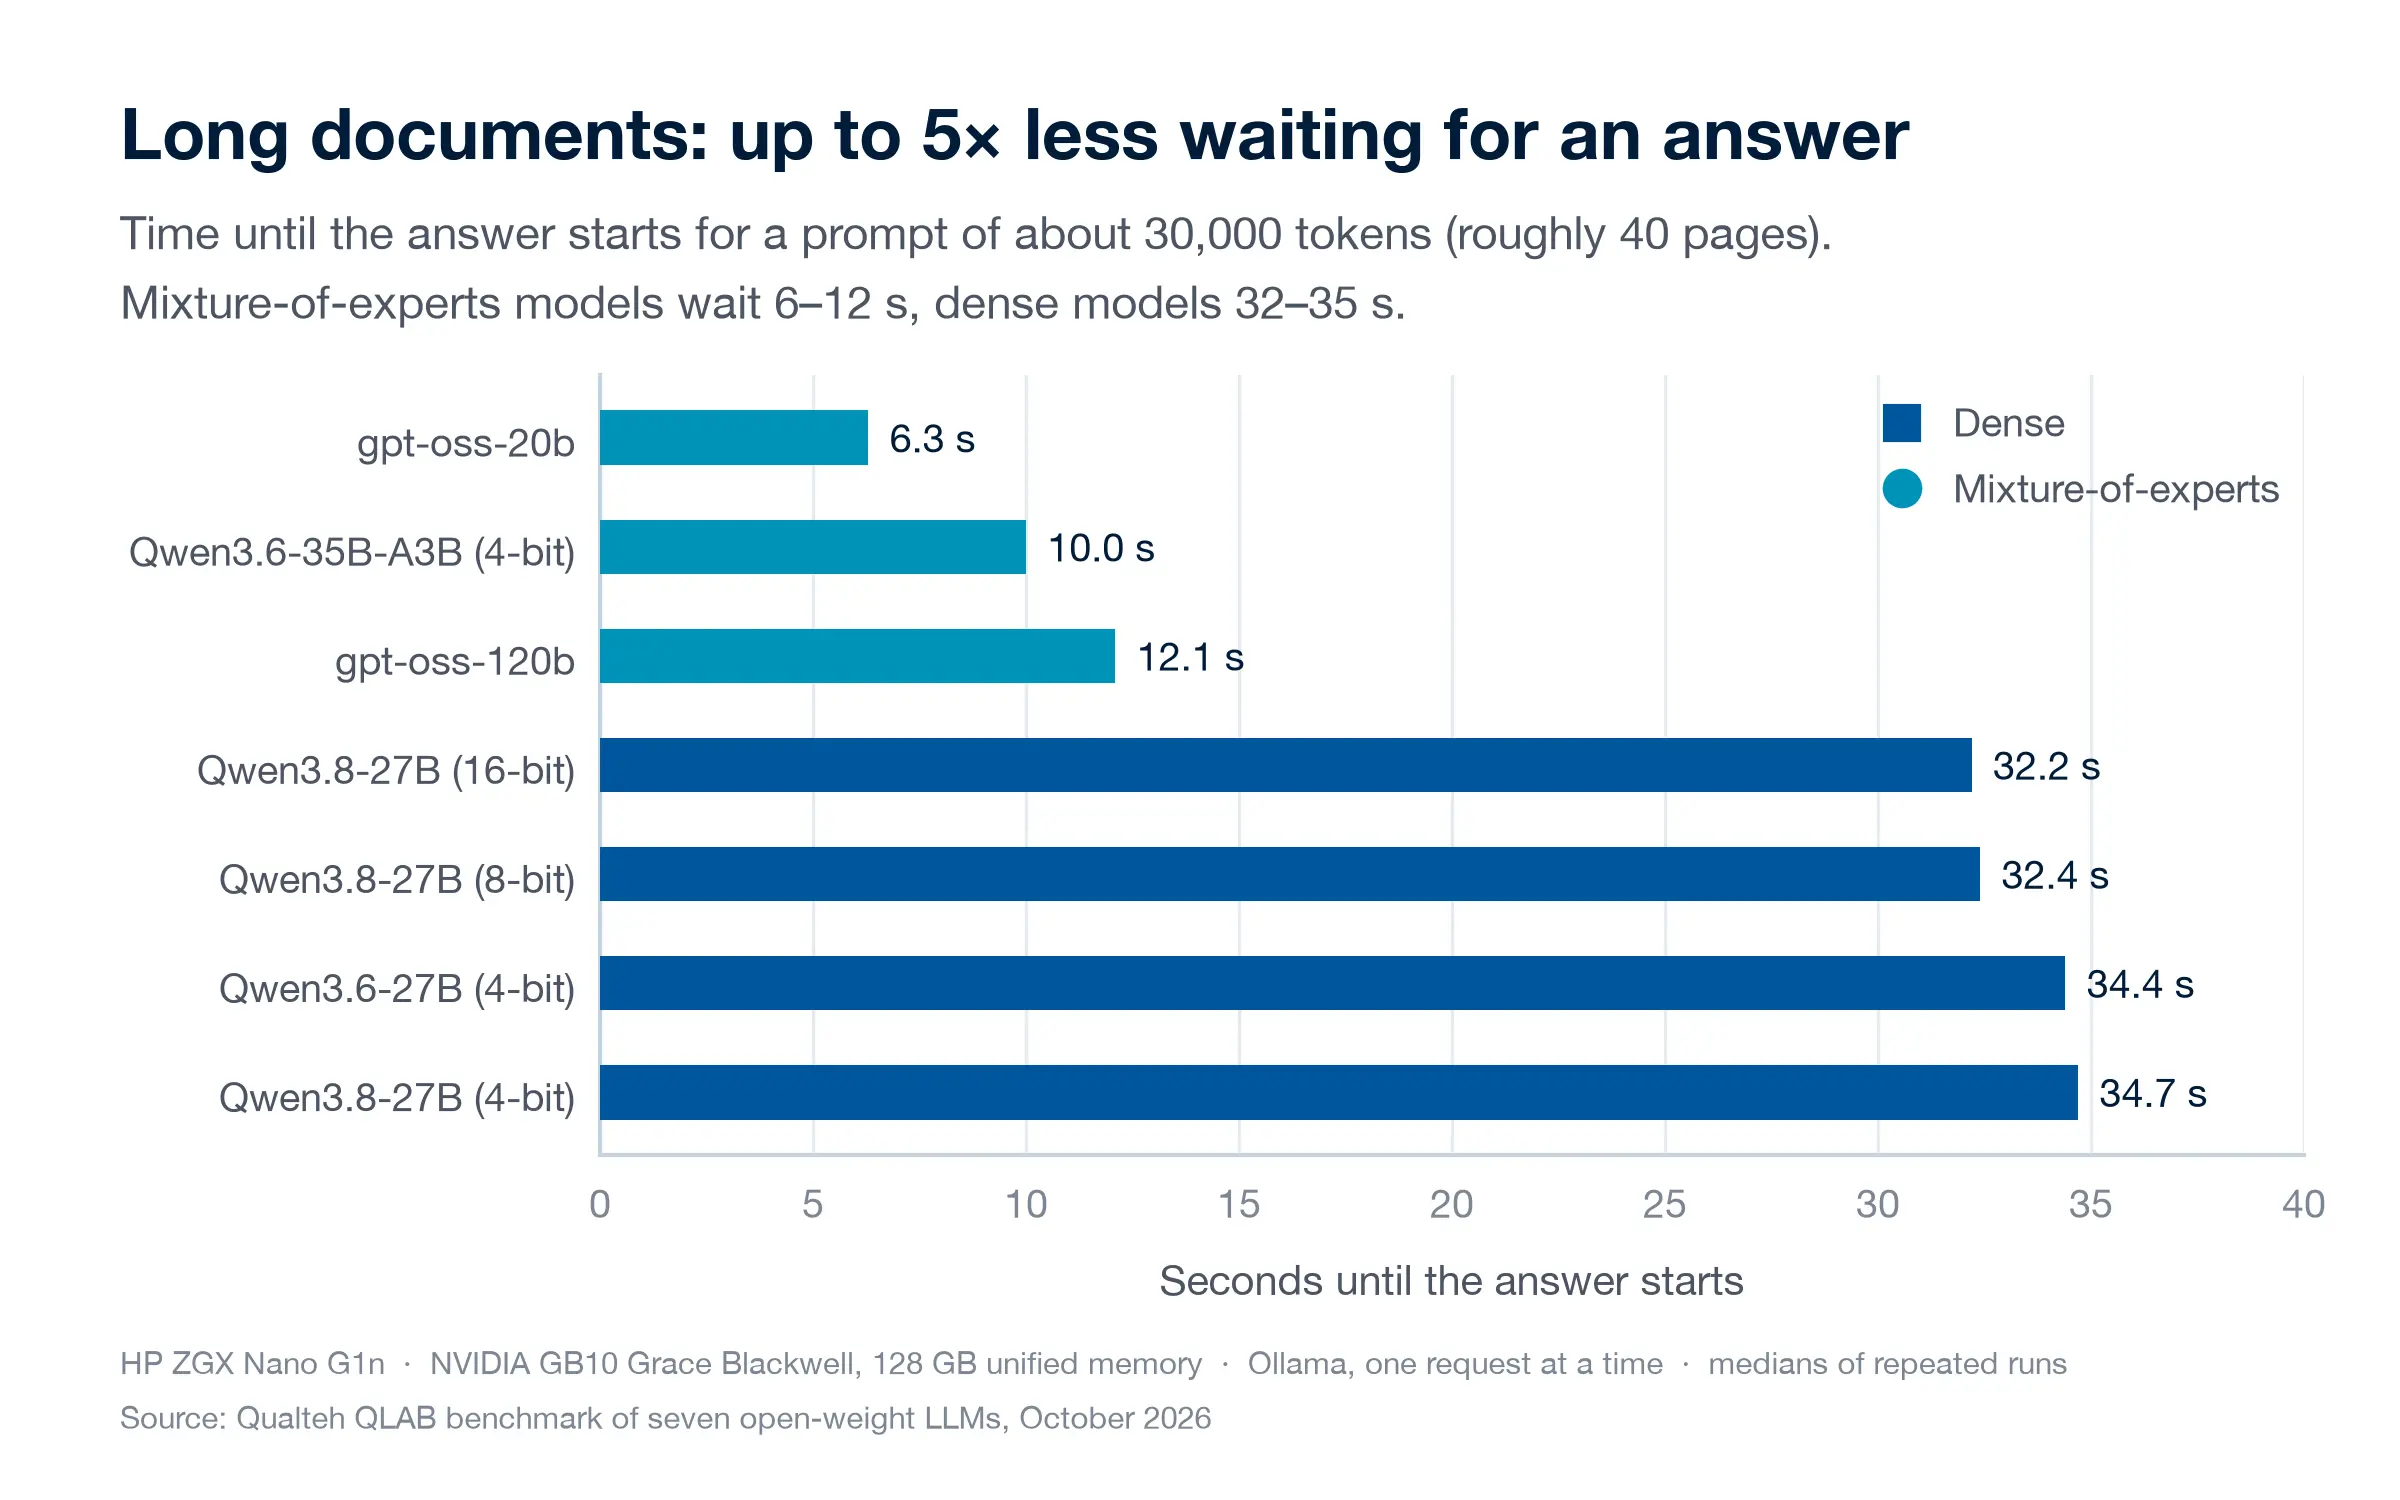 Lange Dokumente: bis zu 5× weniger Warten auf eine AntwortVolle Größe
Bei einem Prompt von etwa 40 Seiten begannen die Mixture-of-Experts-Modelle nach 6–12 Sekunden zu antworten, die Dense-Modelle nach 32–35. Diese Wartezeit spüren Nutzer, wenn ein Assistent lange Handbücher, Verträge oder Berichte liest.
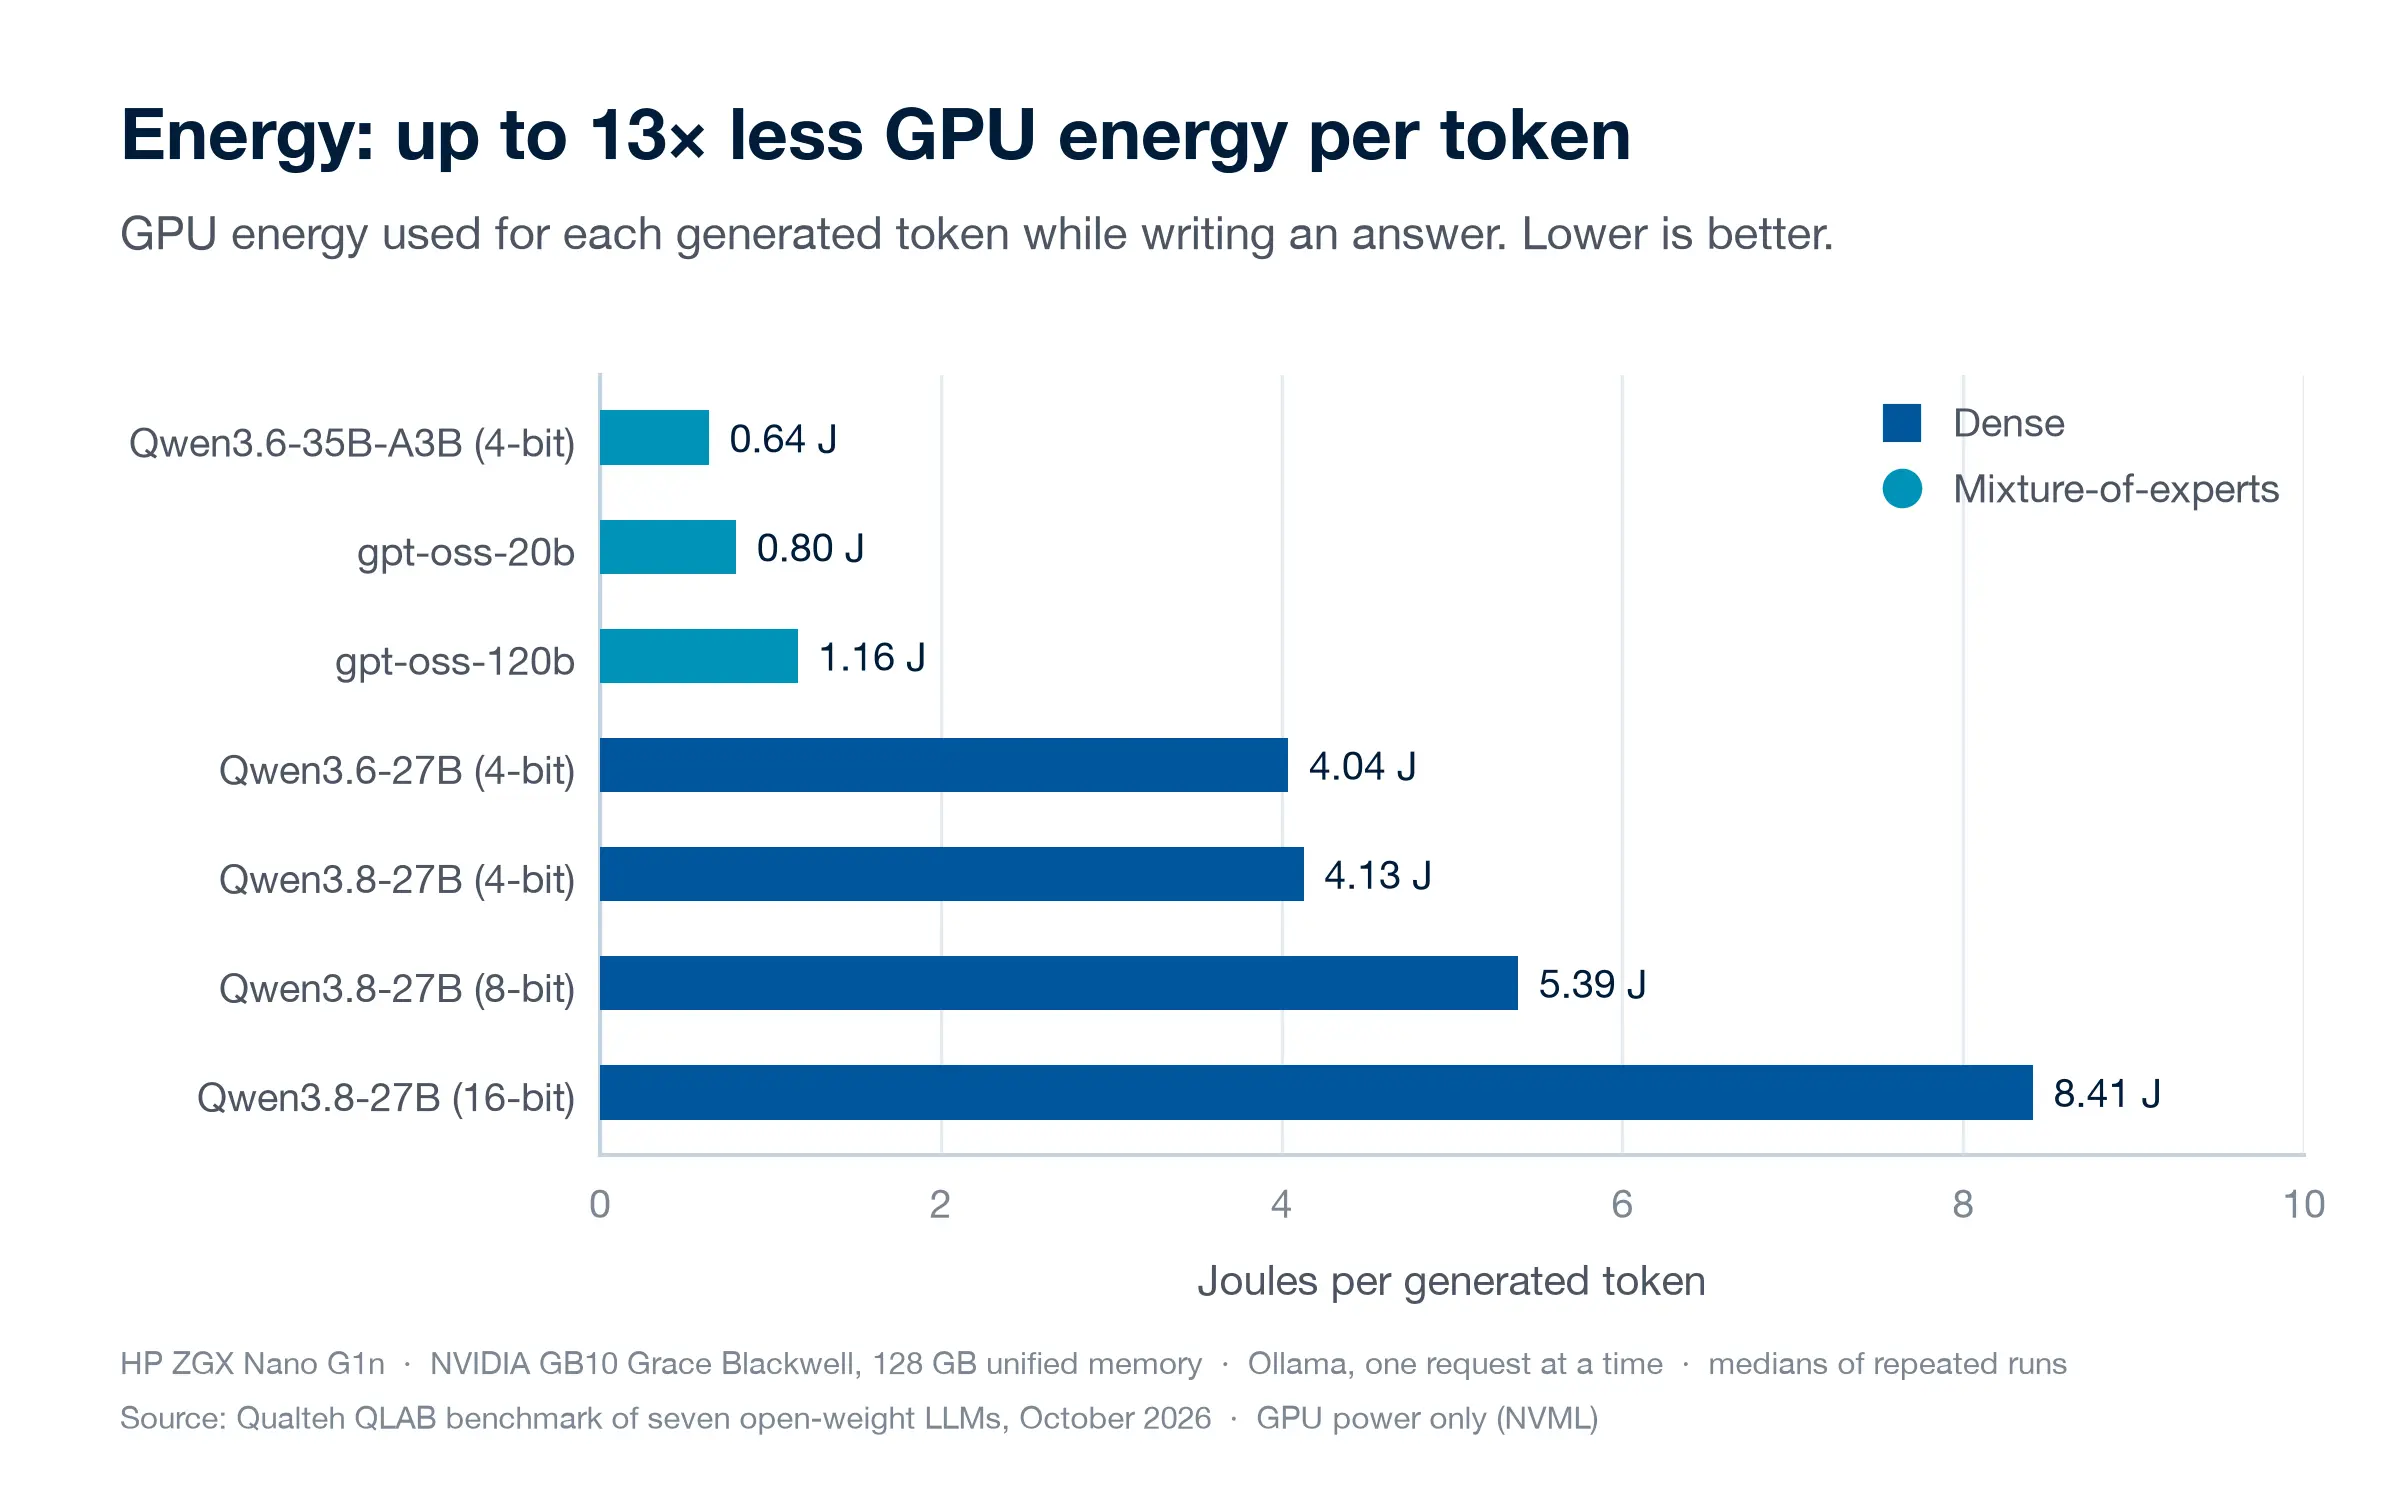 Energie: bis zu 13× weniger GPU-Energie pro TokenVolle Größe
Weil sie für jedes Token nur einen Teil ihrer Gewichte nutzen, brauchten die Mixture-of-Experts-Modelle 0,64–1,16 J pro Token, die Dense-Modelle dagegen 4,04–8,41 J. Bei einem System, das den ganzen Tag läuft, summiert sich dieser Unterschied.
So haben wir getestet
- Hardware
- HP ZGX Nano G1n AI Station mit einem NVIDIA GB10 Grace Blackwell Chip. Die 128 GB Unified Memory teilen sich CPU und GPU, sodass selbst das größte getestete Modell, gpt-oss-120b mit 65 GiB, auf ein einzelnes Gerät passt.
- Modelle
- Sieben Konfigurationen von Open-Weight-Modellen, die vollständig auf eigener Hardware laufen können: drei Mixture-of-Experts-Modelle (gpt-oss-20b, gpt-oss-120b, Qwen3.6-35B-A3B) und zwei Dense-Modelle mit 27B Parametern (Qwen3.6-27B sowie Qwen3.8-27B mit 4, 8 und 16 Bit).
- Gemessen
- Generierungsgeschwindigkeit, belegter Speicher, Zeit bis zum Beginn der Antwort bei einem Prompt von etwa 30.000 Tokens, GPU-Energie pro generiertem Token und Antwortqualität bei einer kleinen Aufgabenauswahl.
Gemessen mit Ollama, jeweils eine Anfrage, auf unserem eigenen Gerät (18.–19. Oktober 2026). Die Werte sind Mediane wiederholter Läufe; die Leistungsaufnahme bezieht sich nur auf die GPU. Die Qualitätsaufgaben sind wenige, daher ist das Ergebnis ein Hinweis, keine Rangliste.
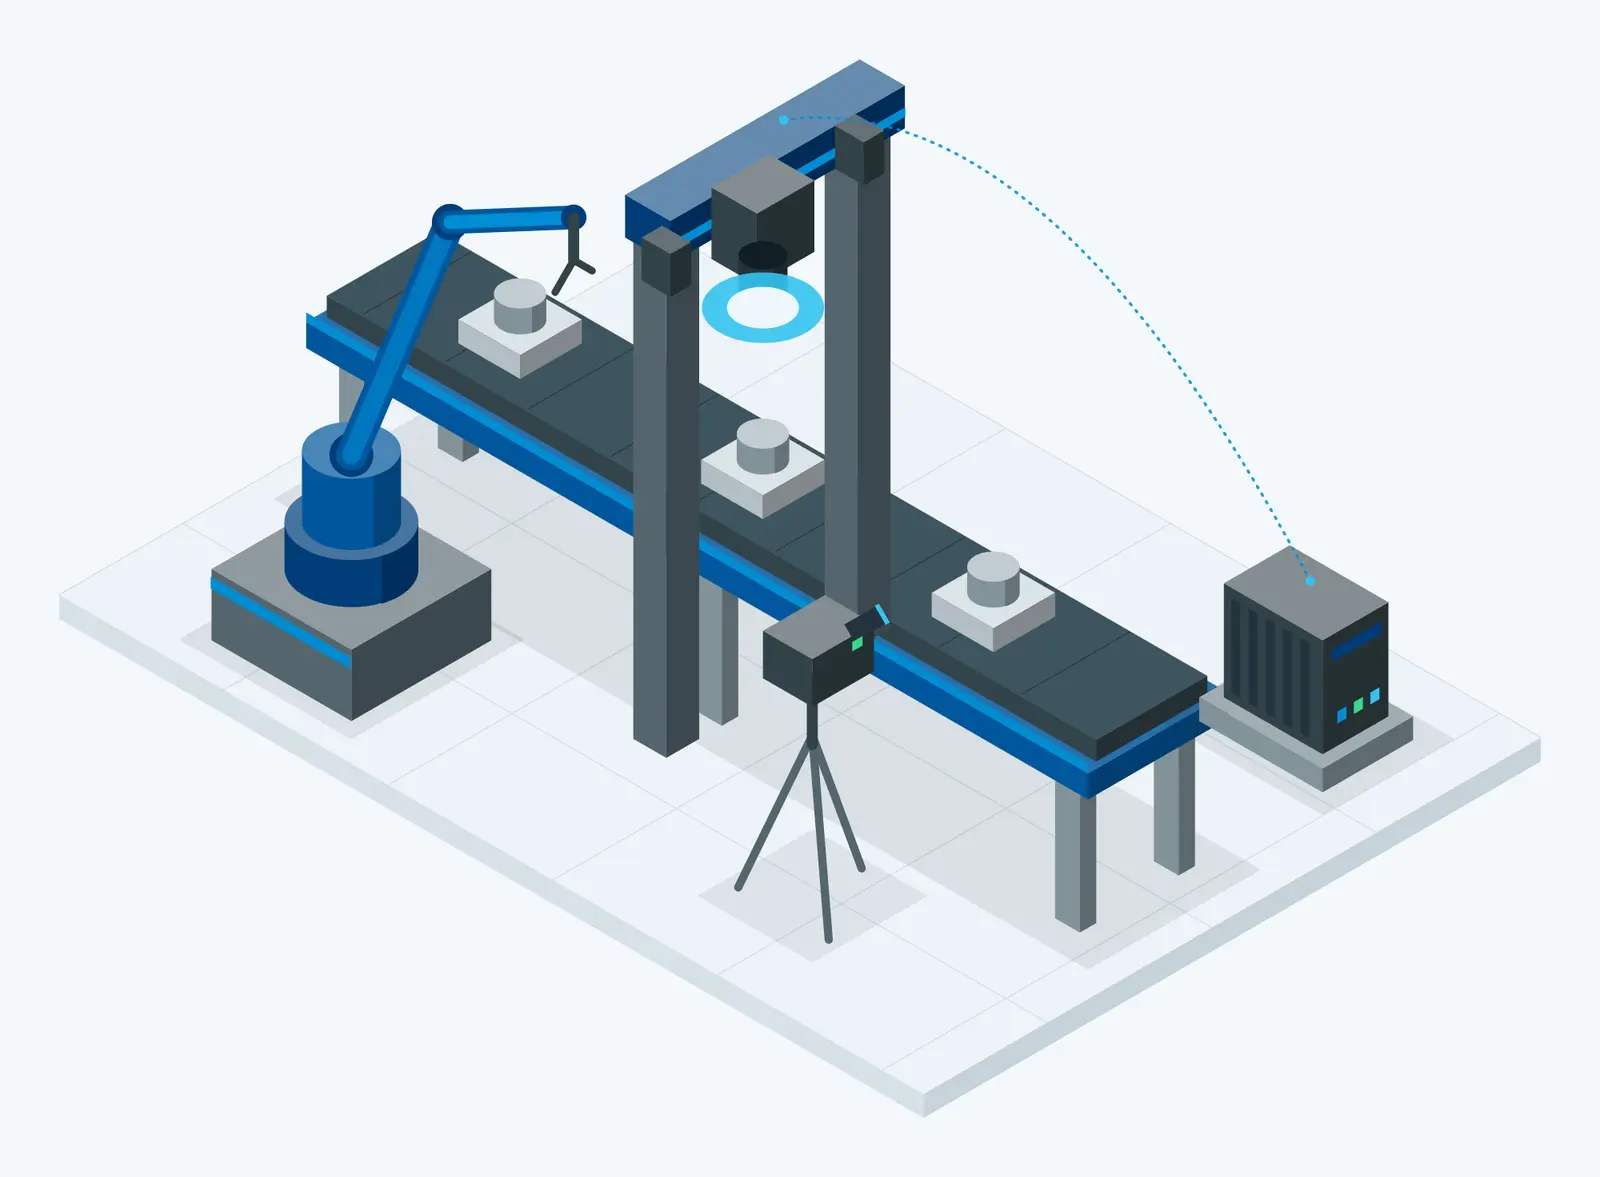
Vom Konzept zur Serienreife — ohne Produktionsrisiko
Wir bauen Ihre Produktionsbedingungen im Labor nach — Teile, Bewegung, Optik, Beleuchtung und Rechenleistung — und liefern einen Proof-of-Concept, getestet auf echter Industriehardware.
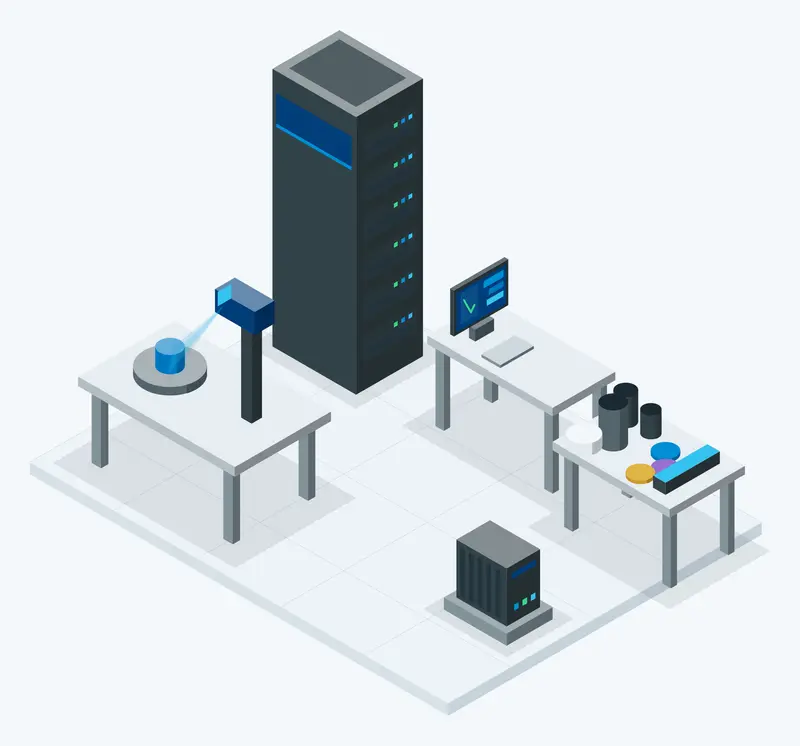
Industrieller Edge-KI-Server
Industrielle Edge-KI-Computer
Roboterarme
Förderbänder
Industrielle 2D-Kameras
Industrielle Objektive & Filter
Industriebeleuchtung
Hochpräzisions-3D-Scanner
Inspektionstische & -ständer
Neueste KI-Modelle
Exzellenter Technologie-Stack
Expertenteam aus Ingenieuren
Wie wir arbeiten
- 1
Analyse & Machbarkeitsstudie
Wir analysieren Ihren Prozess, Ihre Teile und Qualitätsanforderungen und definieren messbare Erfolgskriterien.
- 2
Aufbau der Laborzelle
Wir bauen Ihre Inspektionszelle in QLAB auf: Kameras, Optik, Beleuchtung, Bewegung und Edge-Rechenleistung.
- 3
Individuelles KI-Training
Wir erfassen Daten Ihrer realen Teile und trainieren dedizierte, hochmoderne KI-Modelle für Ihren Fall.
- 4
Im Labor getesteter PoC
Die vollständige Lösung läuft im Labor von Anfang bis Ende und wird gegen die vereinbarten Kriterien validiert.
- 5
Produktionseinführung
Erst dann deployen wir in Ihrer Produktionsumgebung — planbar und mit minimalen Unterbrechungen.
Betrieben durch SYONEEX.AI
VISYA
Industrielle visuelle KI für Qualitätsinspektionen, IO/NIO-Entscheidungen, schrittweise Produktionsüberwachung und Datenanalyse zur kontinuierlichen Verbesserung — 24/7, in jeder Größenordnung.
VISYA entdecken →KI-AgentSYA
Individuelle KI-Agenten, die Mitarbeitern, Partnern und Kunden direkten, intelligenten Zugang zu Unternehmenssystemen, Dokumentationen und Wissen bieten — ohne Suchen, ohne Reibungsverluste.
SYA entdecken →Ingenieure, die Software, Optik, KI — und die Fabrikhalle sprechen
Produktflyer herunterladen
Eine kompakte Übersicht dieser Lösung — alles, was Sie mit Ihrem Team oder Entscheidungsträgern teilen müssen.
Bereit für eine Demo?
Schließen Sie sich den globalen Unternehmen an, die auf Qualteh setzen.